向量数据库
向量数据库是专门存储、管理、检索高维向量的数据库,核心能力是近似最近邻搜索(ANN),通过索引算法在高维空间快速找到与查询向量最相似的数据,解决传统数据库无法高效处理语义检索的痛点
传统数据库vs向量数据库
| 特性 | 传统数据库 | 向量数据库 |
|---|---|---|
| 存储对象 | 结构化数据(表、行、列) | 高维向量、元数据、原文 |
| 检索方式 | 精确匹配、模糊查询 | 语义相似性检索(ANN) |
| 适用场景 | 事务处理、精确查询 | RAG、推荐、图像检索、多模态 |
| 性能表现 | 高维向量检索极慢 | 百万级向量毫秒级响应 |
相似性搜索
相似性搜索 (也称为向量搜索、向量相似性搜索或语义搜索) 是指人工智能应用程序根据指定的相似性度量标准,从数据库中高效地检索与给定查询的向量嵌入在语义上相似的向量的过程
- 欧几里得距离
测量各点之间的直接距离。这对于总体差异至关重要的密集特征集的聚类或分类非常有用
- 余弦相似度
关注向量之间的角度。非常适合文本处理和信息检索,根据方向 (而非传统的距离) 捕获语义相似性
- 曼哈顿距离
计算笛卡尔坐标中的绝对差值之和。适用于类网格结构中的路由选择和优化问题。这对于稀疏数据很有用
向量数据库列表
| 名称 | 特点 | 适合场景 |
|---|---|---|
| Milvus(Zilliz) | Apache2.0,云原生分布式,生态最成熟,支持千亿向量,中文生态好;托管版:Zilliz Cloud | 企业级大规模 RAG、多租户、高吞吐写入、私有化生产 |
| Qdrant | Rust 编写,性能强、资源占用低,payload 过滤能力优秀,API 简洁 | 百万~千万级向量、低延迟检索、实时推荐、中小型生产 RAG |
| Weaviate | BSD3,原生混合检索(向量 + BM25),支持对象模型、多租户,内置向量化模块 | 知识库、需要关键词 + 向量混合检索、SaaS 应用 |
| Chroma | Apache2.0,极简轻量,可内嵌,LangChain 默认集成,上手最快 | 本地原型、Notebook 调试、小体量 Demo,不适合超大生产 |
| LanceDB | 基于 Lance 格式,本地嵌入式为主,支持磁盘存储,适合多模态 | 本地 AI、边缘设备、离线检索、小数据集 |
| Vearch | 国产开源,阿里早期开源,图像视频向量检索优化 | 图像、视频检索场景 |
嵌入模型
嵌入模型会将各种数据 (例如文本、图像、图表和视频) 转换为数值向量,以便捕捉其在多维向量空间中的含义和细微差别。嵌入技术的选择取决于应用需求,同时要兼顾语义深度、计算效率、要编码的数据的类型、维度等因素
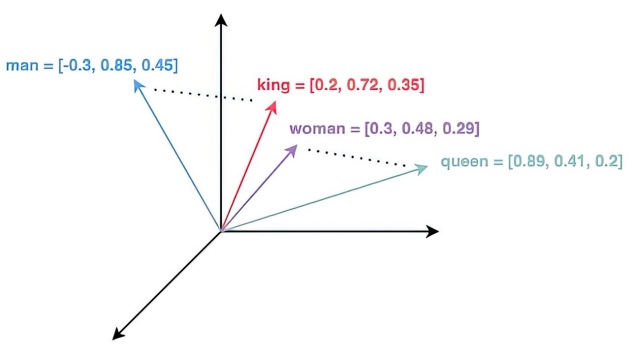
嵌入模型与向量数据库搭配
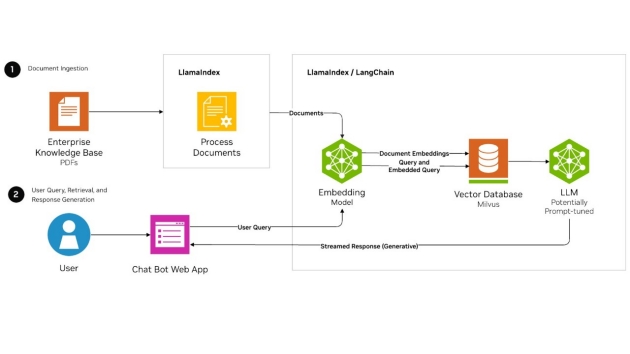
提取私有企业数据后,系统会将这些数据分块,创建一个向量来表示它们,并将数据块及其对应的向量同可选的元数据一起存储在向量数据库中,以供日后检索